
Connection Pool V2 in Microsoft.Data.SqlClient — schneller ist nicht immer schneller
Connection Pool V2 in Microsoft.Data.SqlClient — schneller ist nicht immer schneller
Beschleunigt der neue Connection-Pooling-Mechanismus tatsächlich .NET-Anwendungen? Microsoft hat eine neue Pool-Implementierung in Microsoft.Data.SqlClient vorgestellt, die das parallele Öffnen neuer physischer Verbindungen optimieren soll. Ich habe sie in meinem eigenen Labor mit SQL Server 2022 getestet.
Angefangen hat alles mit einem kleinen Benchmark. Darauf folgten 500 Testläufe in zufälliger Reihenfolge, weitere 280 Diagnosemessungen und schließlich Traces mit dotnet-trace sowie CPU-Sampling mit PerfView. Das Ergebnis? Bei OpenAsync() liegt Pool V2 klar vorn. Bei 500 gleichzeitig ausgeführten synchronen Open()-Aufrufen war V2 in meinem Labor dagegen langsamer als V1.
Hier wird nicht die Ausführungszeit von SQL-Abfragen gemessen. Untersucht werden die Kosten für den Aufbau eines kalten Verbindungspools. Diese Unterscheidung ist entscheidend.
Was hat sich am Verbindungspool geändert?
Bei der älteren Implementierung (hier Pool V1) ist die Erstellung neuer Verbindungen innerhalb eines Pools in erheblichem Maß serialisiert. Pool V2 organisiert die Parallelität anders und nutzt unter anderem System.Threading.Channels, um physische Verbindungen effizienter parallel zu erstellen.
Bei vielen gleichzeitigen Verbindungsöffnungen sollte das besonders asynchronen Operationen zugutekommen. Mehr Parallelität kann allerdings auch die Kosten auf Clientseite erhöhen: für Authentifizierung, Laufzeitumgebung, Threadverwaltung und Betriebssystemfunktionen. Deshalb habe ich neben der verstrichenen Zeit (Wall-Clock Time) auch die CPU-Zeit gemessen. Die Wall-Clock Time ist die Zeit vom Beginn bis zum Ende einer Operation – unabhängig davon, ob die CPU gearbeitet oder die Anwendung gewartet hat. In .NET lässt sie sich mit Stopwatch messen.
Testumgebung und Methodik
| Komponente | Konfiguration |
|---|---|
| Anwendung | C#, .NET 10, Release |
| Client | Microsoft.Data.SqlClient 7.1.0 |
| Server | SQL Server 2022, localhost, Datenbank master |
| Betriebssystem | Windows |
| Authentifizierung | Integrated Security=True |
| Verschlüsselung | Encrypt=True;TrustServerCertificate=True (nur im Labor) |
| Werkzeuge | PowerShell 7, dotnet-trace, PerfView |
| SQL-Abfragen | Keine; gemessen wurde nur das Öffnen von Verbindungen |
Beispiel für einen Connection String:
| |
In jedem Durchlauf wurde die vorgegebene Anzahl an Verbindungen geöffnet. Diese blieben bis zum Ende der Öffnungsphase bestehen, damit das Schließen und Wiederverwenden von Verbindungen die Messung nicht verfälschte. Gemessen wurde die Zeit für das vollständige Verbindungskontingent, nicht die Summe der Ausführungszeiten einzelner Aufrufe.
Der Haupttest umfasste 500 Testläufe mit V1/V2, Open()/OpenAsync() und Parallelitätsstufen von 10, 25, 50, 100, 200 und 500. Die Konfigurationen wurden mit dem reproduzierbaren Zufalls-Seed 20261104 durchmischt. Jeder Testlauf startete in einem neuen .NET-Prozess mit einem kalten Pool. Pro Konfiguration ergaben sich ungefähr 20–21 Messungen; einige Zellen der Zusammenfassung enthielten 20 gültige Läufe. Die Auswertung berücksichtigt daher erfolgreich abgeschlossene Durchläufe.
Anschließend folgten 280 Diagnosemessungen: sieben Stufen (200 bis 500 in 50er-Schritten), zwei Implementierungen, zwei Betriebsarten und jeweils zehn Wiederholungen. Bei diesen Messungen wurde die Vorbereitung der Worker von der zeitlich erfassten Phase des Verbindungsaufbaus getrennt.
Ergebnis 1: OpenAsync() — V2 gewinnt
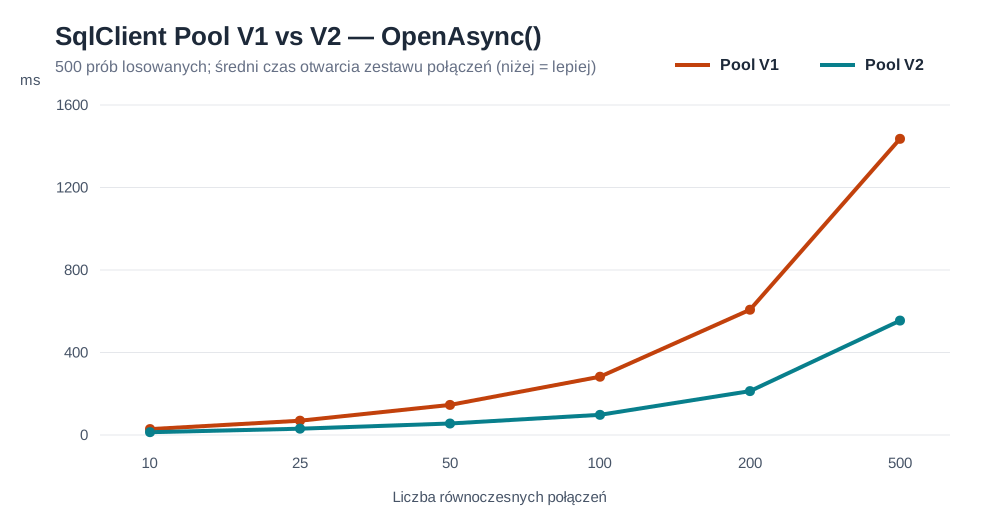
Die folgende Grafik zeigt die mittlere Zeit zum Öffnen aller Verbindungen im Test mit 500 Durchläufen.
| Gleichzeitige Verbindungen | Pool V1 | Pool V2 | Beschleunigung durch V2 |
|---|---|---|---|
| 10 | 28,80 ms | 13,79 ms | 2,09× |
| 25 | 69,38 ms | 30,75 ms | 2,26× |
| 50 | 145,88 ms | 55,67 ms | 2,62× |
| 100 | 282,55 ms | 97,70 ms | 2,89× |
| 200 | 607,43 ms | 212,84 ms | 2,85× |
| 500 | 1435,96 ms | 554,77 ms | 2,59× |
Bei 500 Verbindungen reduzierte V2 die mittlere Zeit von etwa 1,44 s auf 0,55 s. Auch im unabhängigen Diagnosetest mit 500 OpenAsync()-Aufrufen ergaben sich 1399,16 ms (V1) und 463,07 ms (V2), entsprechend einer 3,02-fachen Beschleunigung. Beide Experimente zeigen dieselbe Tendenz: Beim Aufbau eines kalten Pools mit hoher asynchroner Parallelität bringt der neue Mechanismus einen messbaren Vorteil.
Ergebnis 2: synchrones Open() — der Vorteil verschwindet
Im Haupttest mit 500 Durchläufen war V2 bei 10 bis 200 Verbindungen schneller. Bei 500 kehrte sich das Ergebnis um: V1 benötigte 1595,79 ms, V2 hingegen 1951,63 ms. Gemessen am Zeitverhältnis V2/V1 war V2 damit rund 22,3 % langsamer.
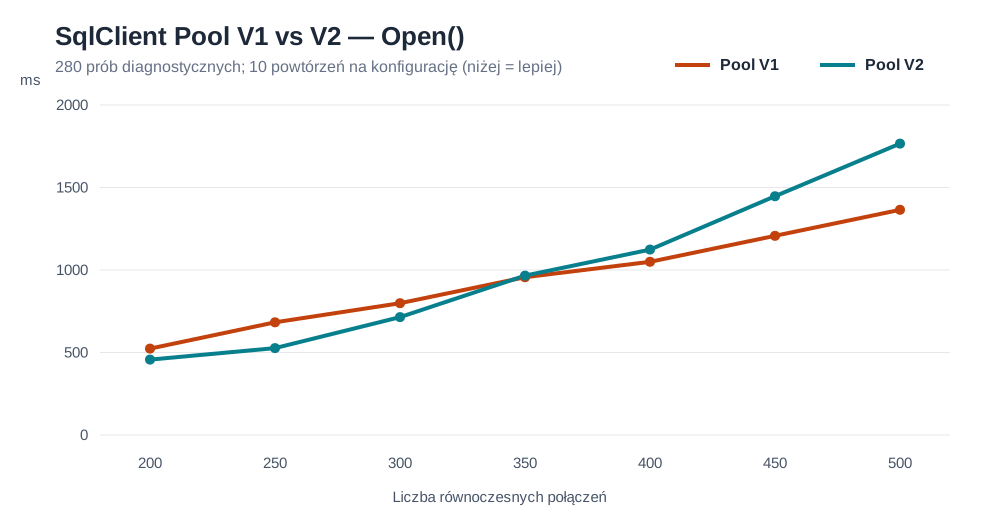
Um zu prüfen, ob es sich um einen einmaligen Ausreißer handelte, habe ich 280 weitere Durchläufe mit engeren Messabständen zwischen 200 und 500 Verbindungen durchgeführt:
| Gleichzeitige Verbindungen | Pool V1 | Pool V2 | Beschleunigung durch V2 |
|---|---|---|---|
| 200 | 523,55 ms | 457,02 ms | 1,15× |
| 250 | 682,90 ms | 526,61 ms | 1,30× |
| 300 | 798,80 ms | 714,50 ms | 1,12× |
| 350 | 956,20 ms | 965,86 ms | 0,99× |
| 400 | 1049,80 ms | 1123,84 ms | 0,93× |
| 450 | 1207,03 ms | 1447,06 ms | 0,83× |
| 500 | 1364,86 ms | 1765,86 ms | 0,77× |
In dieser Messreihe lag der Schnittpunkt bei ungefähr 350 Verbindungen. Bei 500 synchronen Verbindungen war V2 etwa 29,4 % langsamer. Das ist keine allgemeingültige Grenze für SqlClient, sondern ein Ergebnis dieser konkreten Last und Testumgebung.
Was verraten die CPU-Metriken?
Zusätzliche Kennzahlen halfen dabei, die Vorbereitung der Worker von der eigentlichen Clientaktivität zu unterscheiden. Für 500 synchrone Verbindungen ergab die Diagnoseserie:
| Kennzahl | Pool V1 | Pool V2 |
|---|---|---|
| Mittlere kumulierte CPU-Zeit des Prozesses | 1117 ms | 4445 ms |
| Maximale Threadanzahl | 513 | 514 |
| Mittlere Vorbereitungszeit der Worker | 52,1 ms | 49,7 ms |
| Verwaltete Speicherallokationen | 22,0 MiB | 23,0 MiB |
V2 verbrauchte in dieser Serie ungefähr viermal so viel kumulierte CPU-Zeit, obwohl die Vorbereitungszeit der Worker und die maximale Threadanzahl ähnlich waren. Das ist ein deutlicher Anlass für weitere Profilierung, aber noch kein Beweis für einen Fehler im Algorithmus.
Die OpenAsync()-Ergebnisse zeigen außerdem, dass diese zusätzliche Aktivität nicht für jeden Ausführungspfad von V2 charakteristisch ist.
PerfView: eine Ebene tiefer analysieren
Anschließend habe ich mit PerfView ETW-Traces für V1/Sync/500 und V2/Sync/500 aufgezeichnet. In beiden Varianten wurden jeweils fünf erfolgreiche Durchläufe mit 500 Verbindungen und ohne Fehler abgeschlossen. In dieser Phase liefen die Durchläufe innerhalb eines Prozesses mit ClearAllPools(). Damit unterscheiden sich die Bedingungen vom Experiment mit einem neuen Prozess pro Testlauf.
| Profilierte Implementierung | Mittlere Zeit zum Öffnen aller Verbindungen |
|---|---|
| V1, Sync, 500 | 1374,06 ms |
| V2, Sync, 500 | 1826,04 ms |
Auch unter dem Profiler war V2 ungefähr 32,9 % langsamer. Diese Zeiten dürfen jedoch nicht unmittelbar mit Messungen ohne Profiler vermischt werden.
Nach dem Laden der Windows-Symbole fanden sich in den CPU-Samples unter anderem folgende Kernel-Funktionen:
ntoskrnl!ObpLookupObjectName— Suche nach Kernelobjekten anhand ihres Namens;ntoskrnl!ExAllocateHeapPoolundExFreePoolWithTag— Zuweisung und Freigabe von Kernelspeicher;ntoskrnl!SwapContext— Kontextwechsel;ntoskrnl!KeWaitForSingleObject— Warten auf ein Objekt.
Beispielhafte Exc-Werte (Sampling-Metrik von PerfView):
| Funktion | V1 Exc | V2 Exc |
|---|---|---|
ObpLookupObjectName | 24 | 741 |
ExAllocateHeapPool | 54 | 654 |
ExFreePoolWithTag | 35 | 578 |
SwapContext | 39 | 390 |
Das sind weder Aufrufzahlen noch exakt einer Funktion zugeordnete Laufzeiten. Die beiden Traces unterscheiden sich hinsichtlich Dauer und Anzahl der Samples. Die Gegenüberstellung weist auf mögliche Ansätze für weitere Analysen hin, erklärt aber für sich genommen noch nicht die Ursache.
In den V2-Traces beobachtete ich außerdem ChannelDbConnectionPool.GetInternalConnection(), die Verarbeitung von Task-Objekten und Warteoperationen. Im Profil erschien auch ein .NET Tiered Compilation Worker. Ein Teil der Kosten umfasst also JIT-Kompilierung und die Arbeit der Laufzeitumgebung. Bei Integrated Security=True spielt zudem die Windows-Authentifizierung eine Rolle.
Arbeitshypothese: Bei extrem hoher synchroner Parallelität können die Vorteile des parallelen Verbindungsaufbaus durch zusätzliche Betriebssystemarbeit, Authentifizierung und Synchronisationsaufwand aufgehoben werden. Die Profilierung hat noch keine konkrete Ursache nachgewiesen. Dafür müsste man CPU-Stacks, JIT-Aktivitäten und native Operationen genauer isolieren.
Sollte Pool V2 deaktiviert werden?
Diesen Schluss würde ich nicht ziehen. In meinen Tests gewann der asynchrone Pool V2 durchgehend, während synchrones V2 bei geringerer Parallelität ebenfalls schneller war. Die gleichzeitige Erstellung von 500 neuen physischen Verbindungen ist ein Grenzlasttest und kein typischer Dauerzustand einer ordentlich funktionierenden Anwendung.
In der Praxis ist die Wiederverwendung von Verbindungen aus einem bereits aufgebauten Pool besonders wichtig. Mein Experiment untersuchte weder den Durchsatz von SQL-Abfragen noch die Anwendungslatenz mit einem warmen Pool. Auch ein entfernter SQL Server, Azure SQL und Linux waren nicht Gegenstand des Vergleichs.
Für .NET-Entwickler bedeutet dies: Reale Lastmuster messen und Open() von OpenAsync() unterscheiden. Für SQL-Server-Administratoren ist es eine Erinnerung daran, dass nicht jede in der Anwendung sichtbare Verzögerung vom Datenbankmodul verursacht wird. Probleme können entstehen, bevor eine SQL-Abfrage überhaupt den Optimierer erreicht — etwa in SqlClient, bei der Authentifizierung, in der Laufzeitumgebung oder im Betriebssystem.
Schlussfolgerungen
- In diesem Labor beschleunigte Pool V2
OpenAsync()beim Aufbau eines kalten Pools um bis zu ungefähr das Dreifache. - Bei synchronem
Open()nahm der Vorteil mit steigender Parallelität ab; in wiederholten Tests mit 500 Verbindungen war V2 langsamer. - Das CPU-Profil zeigte deutlich höhere CPU-Kosten des Prozesses und stärkere Aktivitäten im Systemcode, erlaubte aber keine eindeutige Bestimmung des ursächlichen Mechanismus.
- Die Ergebnisse gelten für eine konkrete Konfiguration. Sie sind weder eine Empfehlung, Pool V2 abzuschalten, noch eine allgemeingültige Parallelitätsgrenze.
Die Ausgangsfrage lautete: Ist der neue Pool schneller?
Die Antwort: Ja — aber nicht in jedem Szenario. Deshalb sollten Benchmarks reale Lastmuster abbilden. Und nach den ersten Messergebnissen lohnt es sich, tiefer als bis zu Stopwatch zu analysieren.
Quellcode und Reproduzierbarkeit
Die Benchmark-Anwendung in C# (.NET 10) sowie PowerShell-Skripte für randomisierte Tests, Diagnostik und CPU-Profilierung stehen im SQLManiak-Repository zur Verfügung:
Benchmark-Quellcode — SQLManiak / scripts / SqlClientPoolBenchmark
Der Code befindet sich im Verzeichnis scripts/SqlClientPoolBenchmark. Die Anleitung und Einschränkungen sind in README.md dokumentiert. Die Dateien ermöglichen es, die Messungen in einer isolierten Laborumgebung selbst nachzustellen. 500 gleichzeitige Verbindungen sollten nicht ohne vorherige Prüfung der Auswirkungen auf den Server aufgebaut werden.
Beispieltest:
| |
Die Rohdaten der ETW-Traces und Umgebungsdaten werden nicht veröffentlicht. Die Ergebnisse anderer Benutzer können abweichen.
Quellen und weiterführende Materialien
- Microsoft — Try SqlClient’s new connection pool for faster parallel connections
- Microsoft.Data.SqlClient — Quellcode
- Microsoft PerfView
- Microsoft — dotnet-trace
Die Messungen wurden am 4. November 2026 im SQLManiak-Labor durchgeführt. Alle angegebenen Ergebnisse stammen aus Experimenten auf einem einzelnen Testrechner und garantieren keine vergleichbare Leistung in anderen Umgebungen.