
Connection Pool V2 w Microsoft.Data.SqlClient — szybciej nie zawsze znaczy szybciej
Connection Pool V2 w Microsoft.Data.SqlClient — szybciej nie zawsze znaczy szybciej
Czy nowy mechanizm connection poolingu rzeczywiście przyspiesza aplikacje .NET? Microsoft opisał nową implementację puli połączeń w Microsoft.Data.SqlClient, zoptymalizowaną pod kątem równoległego otwierania nowych fizycznych połączeń. Postanowiłem sprawdzić ją we własnym laboratorium z SQL Server 2022.
Zaczęło się od krótkiego benchmarku, potem było 500 prób w losowej kolejności, następnie 280 dodatkowych pomiarów diagnostycznych, a na końcu ślady dotnet-trace i próbkowanie CPU w PerfView. Wynik? Pool V2 zdecydowanie wygrywa w OpenAsync(), ale przy 500 równoczesnych synchronicznych Open() w moim laboratorium był wolniejszy od V1.
To nie jest test czasu wykonywania zapytań SQL. To test kosztu budowania zimnej puli — i to rozróżnienie ma zasadnicze znaczenie.
Co właściwie zmieniło się w puli?
W starszej implementacji (dalej Pool V1) tworzenie nowych połączeń wewnątrz jednej puli ma istotny element serializacji. Pool V2 zmienia organizację współbieżności i korzysta m.in. z System.Threading.Channels, aby usprawnić równoległe tworzenie fizycznych połączeń.
W przypadku dużej liczby jednoczesnych otwarć zmiana powinna szczególnie pomagać operacjom asynchronicznym. Ale większa równoległość może też zwiększyć koszty po stronie klienta: uwierzytelniania, kodu runtime, zarządzania wątkami i funkcji systemowych. Dlatego oprócz czasu ściennego (Wall-clock time,To czas, jaki upłynął od rozpoczęcia do zakończenia operacji, niezależnie od tego, czy procesor pracował, czy aplikacja na coś czekała.W .NET mierzymy go za pomocą Stopwatch) mierzyłem także CPU.
Środowisko i metodologia
| Element | Konfiguracja |
|---|---|
| Aplikacja | C#, .NET 10, Release |
| Klient | Microsoft.Data.SqlClient 7.1.0 |
| Serwer | SQL Server 2022, localhost, baza master |
| System | Windows |
| Logowanie | Integrated Security=True |
| Szyfrowanie | Encrypt=True;TrustServerCertificate=True (tylko laboratorium) |
| Narzędzia | PowerShell 7, dotnet-trace, PerfView |
| Zapytania SQL | Brak; mierzone było otwieranie połączeń |
Przykładowy connection string:
| |
Każda runda otwierała wskazaną liczbę połączeń, pozostawiając je otwarte do końca fazy otwierania, żeby zamykanie i ponowne wykorzystanie połączeń nie zniekształciło pomiaru. Mierzyłem czas potrzebny do uzyskania całego zestawu, a nie sumę czasów pojedynczych wywołań.
W głównym teście wykonałem 500 prób: V1/V2, Open()/OpenAsync() i poziomy współbieżności 10, 25, 50, 100, 200 oraz 500. Konfiguracje zostały losowo wymieszane z odtwarzalnym ziarnem 20261104, a każda próba startowała w nowym procesie .NET (zimna pula). Na pojedynczą konfigurację przypadało około 20–21 pomiarów; w części komórek podsumowanie miało 20 ważnych prób, dlatego analizuję wartości dla rund poprawnych.
Dalej wykonałem 280 prób diagnostycznych: 7 poziomów (200–500 co 50), 2 implementacje, 2 tryby, po 10 powtórzeń na konfigurację. W tych pomiarach rozdzieliłem przygotowanie workerów od mierzonej fazy otwierania.
Wynik 1: OpenAsync() — V2 wygrywa
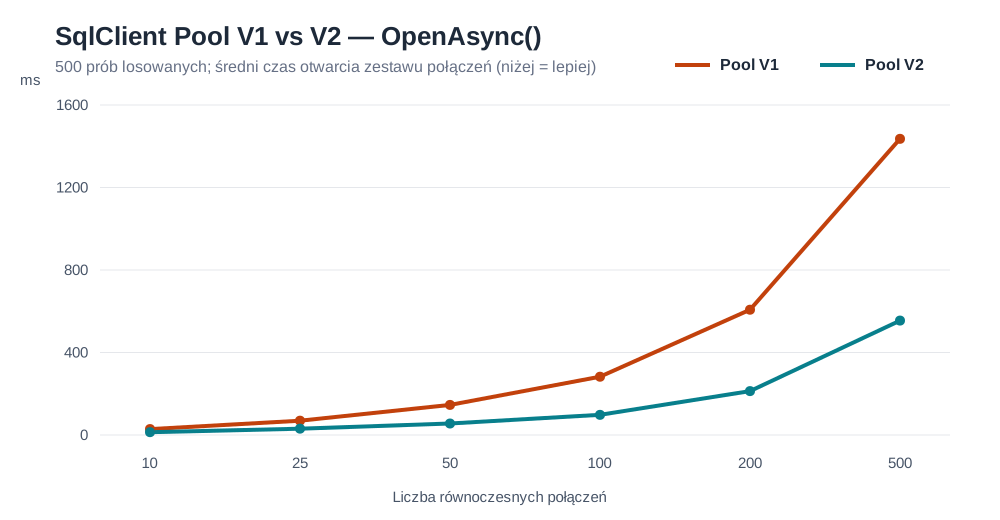
Poniżej średnie czasy otwarcia pełnego zestawu połączeń w teście 500 prób.
| Równoczesne połączenia | Pool V1 | Pool V2 | Przyspieszenie V2 |
|---|---|---|---|
| 10 | 28,80 ms | 13,79 ms | 2,09× |
| 25 | 69,38 ms | 30,75 ms | 2,26× |
| 50 | 145,88 ms | 55,67 ms | 2,62× |
| 100 | 282,55 ms | 97,70 ms | 2,89× |
| 200 | 607,43 ms | 212,84 ms | 2,85× |
| 500 | 1435,96 ms | 554,77 ms | 2,59× |
Przy 500 połączeniach V2 skrócił średni czas z około 1,44 s do 0,55 s. Również w niezależnym teście diagnostycznym dla 500 OpenAsync() uzyskałem 1399,16 ms (V1) i 463,07 ms (V2), czyli 3,02×. Kierunek obu eksperymentów jest spójny: przy zimnej puli i dużej współbieżności asynchronicznej nowy mechanizm daje realny zysk.
Wynik 2: synchroniczne Open() — przewaga znika
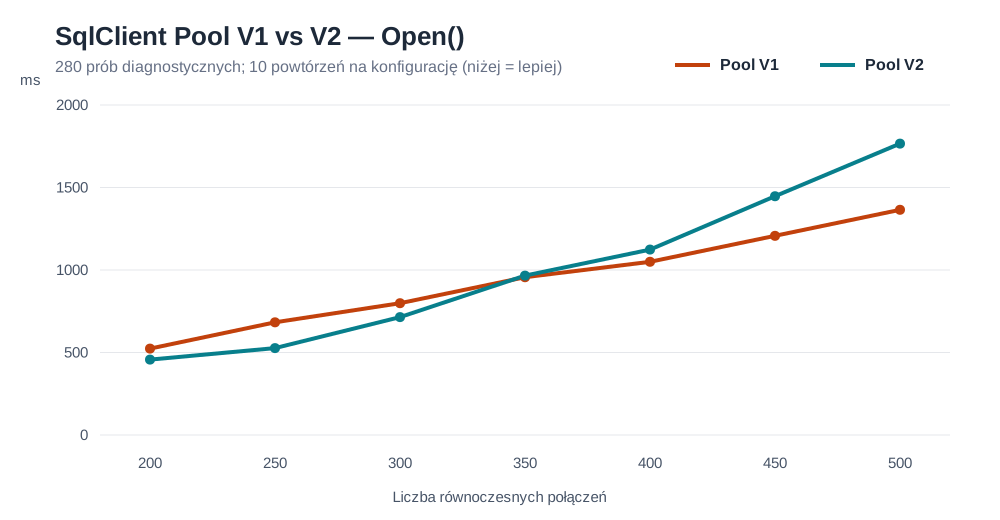
W głównym teście 500 prób V2 wygrywał od 10 do 200 połączeń. Przy 500 nastąpiło odwrócenie: V1 — 1595,79 ms, V2 — 1951,63 ms. V2 był więc o około 22,3% wolniejszy (porównanie czasów V2/V1).
Żeby ustalić, czy to jednorazowe zakłócenie, przeprowadziłem dodatkowe 280 prób, zagęszczając pomiary w przedziale 200–500 połączeń:
| Równoczesne połączenia | Pool V1 | Pool V2 | Przyspieszenie V2 |
|---|---|---|---|
| 200 | 523,55 ms | 457,02 ms | 1,15× |
| 250 | 682,90 ms | 526,61 ms | 1,30× |
| 300 | 798,80 ms | 714,50 ms | 1,12× |
| 350 | 956,20 ms | 965,86 ms | 0,99× |
| 400 | 1049,80 ms | 1123,84 ms | 0,93× |
| 450 | 1207,03 ms | 1447,06 ms | 0,83× |
| 500 | 1364,86 ms | 1765,86 ms | 0,77× |
W tej serii punkt przecięcia wypadł w okolicach 350 połączeń. Przy 500 synchronicznych połączeniach V2 był około 29,4% wolniejszy. Nie jest to uniwersalny próg SqlClient — to wynik konkretnego obciążenia i środowiska.
Co mówią liczniki CPU?
Dodatkowe metryki pomogły oddzielić samo przygotowanie workerów od aktywności klienta. W serii diagnostycznej przy 500 synchronicznych połączeniach:
| Metryka | Pool V1 | Pool V2 |
|---|---|---|
| Średni skumulowany CPU procesu | 1117 ms | 4445 ms |
| Szczytowa liczba wątków | 513 | 514 |
| Średni czas przygotowania workerów | 52,1 ms | 49,7 ms |
| Alokacje zarządzane | 22,0 MiB | 23,0 MiB |
V2 zużywał w tej serii około 4 razy więcej skumulowanego czasu CPU, choć przygotowanie workerów oraz szczytowa liczba wątków były podobne. To silna przesłanka do dalszego profilowania, a nie jeszcze dowód na błąd w algorytmie.
Wyniki OpenAsync() pokazują z kolei, że ta zwiększona aktywność nie jest uniwersalną cechą każdej ścieżki V2.
PerfView: próbowanie zejść poziom niżej
Następnie zebrałem ślady ETW z PerfView dla V1/Sync/500 i V2/Sync/500. W obu wariantach wykonano po pięć poprawnych rund (po 500 połączeń, bez błędów). W tej fazie rundy działały w jednym procesie z ClearAllPools(), zatem warunki nie są identyczne z eksperymentem „nowy proces dla każdej próby”.
| Profilowana implementacja | Średni czas pełnego otwarcia |
|---|---|
| V1, Sync, 500 | 1374,06 ms |
| V2, Sync, 500 | 1826,04 ms |
Także pod profilerem V2 był około 32,9% wolniejszy. Nie należy jednak mieszać bezpośrednio tych liczb z pomiarami bez profilera.
Po załadowaniu symboli Windows w próbkach CPU znalazłem między innymi funkcje jądra:
ntoskrnl!ObpLookupObjectName— wyszukiwanie obiektów jądra;ntoskrnl!ExAllocateHeapPooliExFreePoolWithTag— przydział i zwalnianie pamięci jądra;ntoskrnl!SwapContext— przełączanie kontekstu;ntoskrnl!KeWaitForSingleObject— oczekiwanie na obiekt.
Przykładowe wartości Exc (metryka próbkowania PerfView) wyniosły odpowiednio:
| Funkcja | V1 Exc | V2 Exc |
|---|---|---|
ObpLookupObjectName | 24 | 741 |
ExAllocateHeapPool | 54 | 654 |
ExFreePoolWithTag | 35 | 578 |
SwapContext | 39 | 390 |
To nie są liczniki wywołań ani dokładny czas przypisany do danej funkcji. Obydwa ślady mają inny czas trwania i inną liczbę próbek. Zestawienie pokazuje kierunek dalszej diagnostyki, a nie samodzielnie wyjaśnia przyczynę.
W śladach V2 zauważyłem również ChannelDbConnectionPool.GetInternalConnection(), obsługę Task i operacje oczekiwania. W profilu pojawiał się też .NET Tiered Compilation Worker, czyli część kosztu obejmuje JIT i działanie środowiska uruchomieniowego. Przy korzystaniu z Integrated Security=True w grę wchodzi również uwierzytelnianie Windows.
Hipoteza robocza: przy bardzo dużej synchronicznej współbieżności korzyść z równoległego tworzenia połączeń może zostać zniwelowana przez dodatkową pracę systemową, uwierzytelnianie i koszty synchronizacji. Profilowanie nie dowiodło jeszcze konkretnej przyczyny; wymagałoby to bardziej precyzyjnej izolacji stosów CPU, JIT i natywnych operacji.
Czy trzeba wyłączyć Pool V2?
Nie wyciągałbym takiego wniosku. W moich testach asynchroniczny Pool V2 wygrywał konsekwentnie, a synchroniczny V2 był szybszy przy mniejszej współbieżności. Scenariusz 500 jednocześnie tworzonych fizycznych połączeń jest testem granicznym, nie typowym stanem prawidłowo działającej aplikacji.
W praktyce najważniejsza jest ponowna używalność połączeń z rozgrzanej puli. Mój eksperyment nie badał przepustowości zapytań ani opóźnień aplikacji pracującej na ciepłej puli. Nie porównywał też zdalnego SQL Server, Azure SQL ani Linuksa.
Dla programisty .NET wniosek jest prosty: warto mierzyć rzeczywiste wzorce obciążenia aplikacji oraz odróżniać Open() od OpenAsync(). Dla administratora SQL Server to przypomnienie, że nie każde opóźnienie widoczne w aplikacji pochodzi z silnika bazy danych. Problemy mogą powstawać, zanim jakiekolwiek zapytanie dotrze do optymalizatora — w SqlClient, uwierzytelnianiu, runtime lub systemie operacyjnym.
Wnioski
- Pool V2 zapewnił w tym laboratorium przyspieszenie
OpenAsync()nawet około 3× przy rozbudowie zimnej puli. - Dla synchronicznego
Open()zysk malał wraz z liczbą równoczesnych połączeń; w powtarzanych testach przy 500 V2 był wolniejszy. - Profil CPU pokazał istotnie większy koszt procesu i wzrost aktywności w kodzie systemowym, ale nie pozwolił jednoznacznie ustalić mechanizmu przyczynowego.
- Wynik dotyczy konkretnej konfiguracji. Nie jest rekomendacją wyłączenia Pool V2 ani uniwersalnym limitem współbieżności.
Pytanie otwierające eksperyment brzmiało: czy nowa pula jest szybsza?
Odpowiedź brzmi: tak — ale nie w każdym scenariuszu. I właśnie dlatego benchmarki warto wykonywać na rzeczywistym obciążeniu, a po pierwszych liczbach sięgać głębiej niż Stopwatch.
Kod źródłowy i odtwarzalność eksperymentu
Aplikację benchmarkową w C# (.NET 10) i skrypty PowerShell do testów losowych, diagnostyki oraz profilowania CPU udostępniam w repozytorium SQLManiak:
Kod źródłowy benchmarku — SQLManiak / scripts / SqlClientPoolBenchmark
Kod znajduje się w katalogu scripts/SqlClientPoolBenchmark. Instrukcja uruchomienia i opis ograniczeń znajdują się w README.md. Kod jest udostępniony do samodzielnego powtórzenia pomiarów w odizolowanym laboratorium; nie należy uruchamiać 500 równoczesnych połączeń bez oceny wpływu na serwer.
Przykładowy test:
| |
Nie publikuję surowych śladów ETW ani danych środowiskowych. Wyniki uzyskane przez innych użytkowników mogą się różnić.
Źródła i materiały
- Microsoft — Try SqlClient’s new connection pool for faster parallel connections
- Microsoft.Data.SqlClient — kod źródłowy
- Microsoft PerfView
- Microsoft — dotnet-trace
Pomiary wykonano 4 listopada 2026 r. w laboratorium SQLManiak. Zastosowane wyniki pochodzą z eksperymentów przeprowadzonych na jednym stanowisku; nie są gwarancją wydajności w innych środowiskach.